佛道概念的决策论形式化:可计算的桥与边界
沈马成(研究发起)与 AI 研究助手协作
1. 白话结论
把“开悟”理解成知道得越来越多,直觉上很诱人,但知识更完整并不自动让人放下执著。更稳妥的 H-Bridge 说:只有当一个模型也能看见自己的局限,并允许“有些事不可控”的知识修订原有偏好时,认识增加才可能减少内在冲突。无为最能被形式化的部分,是借助环境自身的动力,只在关键处付出必要控制,而不是什么都不做。知行合一可拆成三个可研究层次:感知与行动共享目标、熟练行动由规划蒸馏而来、某些因果知识必须经干预才能获得。玩具实验支持 H-Bridge 的条件交互和适中自我精度的权衡,但其中的成功只属于预先写下的模型。无为实验反而没有达到预注册成功阈值,因此不能把漂亮的节能结果说成验证。数学能够澄清结构、提出反例,却无法给“纯粹觉知”、良知的道德来源、彻底无意图或存在性之苦下定义。这里的形式化应当被当成可检验的地图,而不是宗教体验或传统本身。
2. 逐概念对照表
| 传统概念 | 形式对象 | 强度 | 主要失真 |
|---|---|---|---|
| 无为 | LMDP:在被动动力学上按可欲性重加权,控制偏离用 KL 计价 | 强控制问题 | 仍预设目标函数,无法表达“连目标也放下” |
| 知行合一 | 控制即推断;规划蒸馏;观察与干预的因果差异 | 强至部分 | 抓到结构,却丢失良知、心即理和道德动机 |
| 开悟 | 任务相对的世界模型误差、偏好精度及其可更新性 | 部分 | “完整模型即开悟”过强;知识也可能加剧冲突 |
| 无我 | 自我隐变量及其精度 \(\gamma_{self}\) | 部分 | 降低僵硬先验不等于证得无我,也不等于删除行动者 |
| 执著、渴爱与苦 | 不可控情境中的高偏好精度与持续风险项 | 部分 | 只能近似“求不得”的冲突,不能穷尽生老病死与行苦 |
| 空 | 模型族、粗粒化与统计不可识别性 | 修辞至部分 | 工程上的“表征无自性”不能替代中观论证;该形式化本身也非终极描述 |
| 缘起 | 结构因果模型与干预分布 | 部分 | 固定变量和因果边,无法承载缘起的全部伦理与本体含义 |
| 止观、元觉知 | 对注意精度分配的二阶推断 | 部分 | 是计算提议,不是已确证的冥想神经机制 |
| 顿悟与渐悟 | 连续证据累积与 MAP 模型的离散翻转 | 部分 | 不包含解脱、伦理转变与传承认证 |
| 中道 | 明确目标下的帕累托前沿 | 修辞至部分 | 不是参数取中间值,也不是一般折中主义 |
| 道法自然、上善若水、反者道之动 | 生成过程、柔顺控制、负反馈 | 修辞 | 若不产生独立预测,就只是现代术语重命名 |
3. 开悟张力:A / B / Bridge 与 T3
H-A:认识完备
探索越充分、模型越准确,冲突就越低。问题是事实知识并不决定偏好:更准确地知道坏结果不可避免,也可能令固定执取更痛苦。
H-B:执取释放
减少执取本身足以降低冲突,不依赖认识增长。问题是若看不见自己的控制冲动及其后果,偏好很难被有针对性地修订。
H-Bridge:条件桥
认识增长只有在两个桥因子同时存在时才导向释放:模型能表征自身建模与控制局限;偏好能被“不可控”的证据更新。
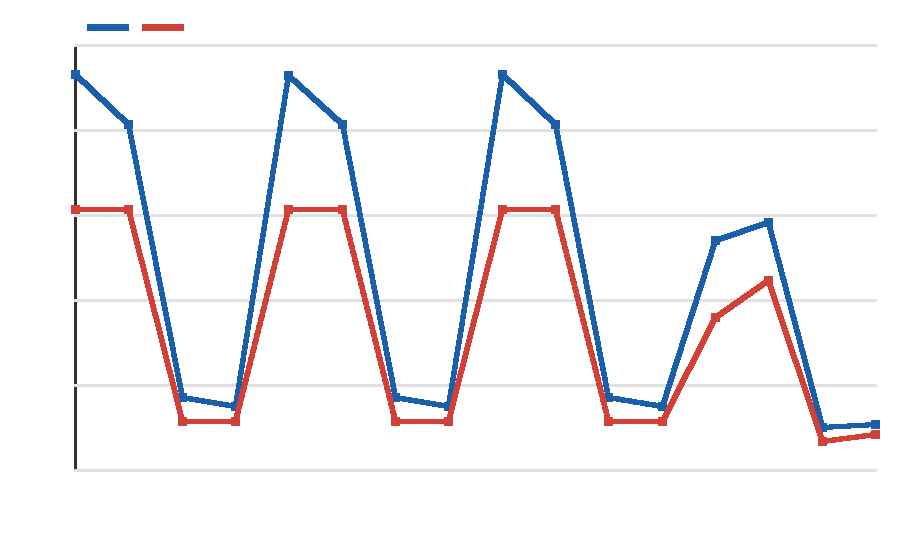
T3 在 16 个条件、每格 800 次的生成性玩具实验中给出清楚的交互:完整桥下,高探索使 distress 改变量为 −1.509;无桥时为 +4.369;双重差分为 −5.878。预设的“桥内外探索效应差小于 1”杀死条件没有触发。它反对 H-A 的无条件充分性,并支持 H-Bridge 在这个模型中的可区分结构;由于机制本来就按 H-Bridge 写入,结果不是对现实心理机制的独立验证。
4. 无为:LMDP 与 T1 负面结果
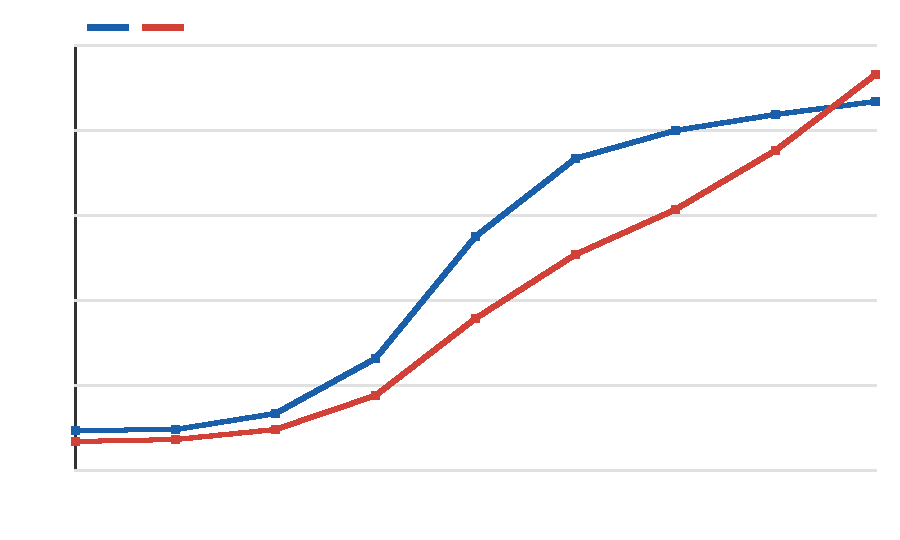
线性可解马尔可夫决策过程把每一步代价写成状态代价与偏离被动动力学的 KL 代价:
这给出一个精确的工程弱版:好控制不是动作归零,而是在自然流上重加权,把控制集中到真正改变可达结果的关键处。它能区分顺势控制、随机漂移和持续蛮力。
5. 知行合一三层
- 统一目标:主动推断把状态估计和行动选择写进同一个优化目标。“知”与“行”在计算上相互约束,而不是先后完全独立的模块。
- 摊销蒸馏:慢速规划器产生策略,再把它蒸馏进快速参数策略。反复实践把显式推演编译成流畅技能,解释“知道如何做”与“做得出来”的差别。
- 干预知识:在存在混杂时,观察 \(P(Y\mid X)\) 一般不能识别干预 \(P(Y\mid do(X))\)。因此某些因果知识必须通过行动获得;这是“知而不行”的严格弱版本。
这三层没有形式化王阳明所说的良知。它们描述统一控制、技能形成与因果识别,而不是证明道德知识先天存在,也不能从性能指标推出“心即理”。
6. T2:自我精度的承诺—恢复权衡
T2 在规则改变的 POMDP 中扫描 \(\gamma_{self}\in\{0,0.35,1,3\}\)。适中精度 \(\gamma_{self}=1.0\) 的总回报最高,为 40.029:精度接近零时恢复快,却较难形成长期承诺;精度很高时承诺强,却在规则反转后恢复慢、累计风险更高。预注册的杀死条件——端点回报最高,或精度既不影响恢复也不影响承诺——没有触发。
futile_control_rate 在所有条件下都等于 1,因为不可控阶段每一步仍被迫选一个动作;这个指标已退化、没有辨别力,结论只依赖累计风险、恢复、承诺与总回报。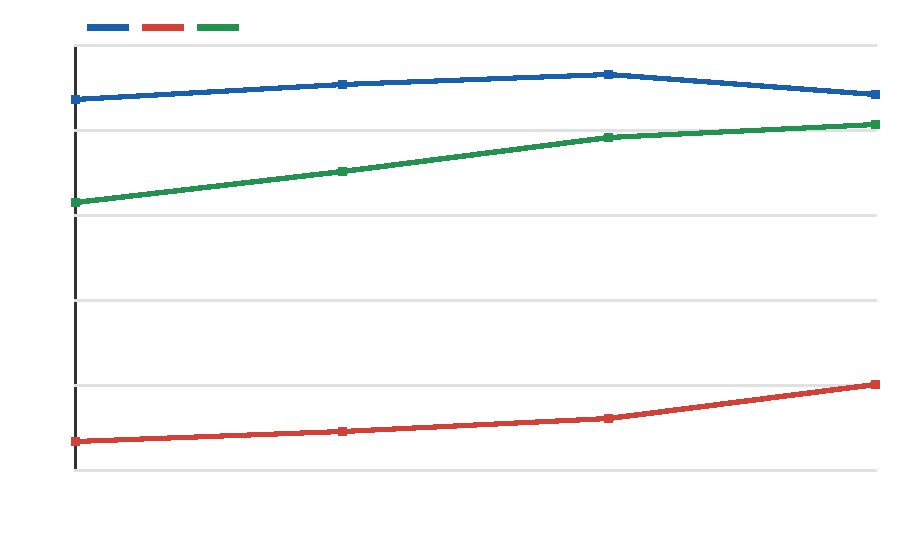
7. 形式化失效处
- 觉知本身:方程可以描述被注意的内容和注意资源如何分配,却没有解释为什么存在体验。
- 良知的道德本体:先验可以编码偏好,却不能仅凭推断框架说明道德法则为何有效、从何而来。
- 无为的无意图性:所有控制模型都预设目标;“高效追求目标”不是“从目标本身脱落”。
- 苦的完整谱系:风险项能模拟欲求与不可控之间的冲突,不能把行苦、生老病死或存在性不满足压成一个预测误差。
- 空对描述语言的反身限制:统计不可识别性只是类比;把信息或模型抬成终极实体,同样会成为被批判的对象。
- 传统内部差异:不同佛教传统对觉悟与全知的关系并无单一答案;顿渐之争、老庄与后世道教也不能被一条学习曲线统一。
8. 两份分析的分歧,以及一般性治理问题
关于“空”
一份分析把模型依赖、粗粒化与不可识别性视为部分可操作对应;另一份更强调:这仍只是认识论类比,中观会进一步质疑“信息”本身是否有终极地位。合并后的立场是:工程对应可用,但强度不得高于“部分”,更不能借它建立新的实体论。
关于“无为”的盲区
形式稿突出 LMDP 的强数学结构和可杀实验;批判稿强调其目标函数从未消失。合并后的立场是:对“少偏离自然动力学的控制”,对应很强;对经典语境中的无意图、自发性与政治伦理,只能部分甚至修辞对应。
紧耦合不等于权力集中
个体或单一系统中的感知—行动紧耦合,是信息快速回流的设计;组织治理中把感知、判断、执行和审查集中给同一节点,则会削弱纠错与问责。二者可兼容,但层级边界必须明确:执行回路可以紧,授权与验证仍应分离;局部的统一目标不能自动成为制度集权的理由。
9. 可证伪预测
- 无为控制:若目标与自然吸引子对齐,应存在高成功率、低 KL 的控制点,且控制成本集中在势垒附近。T1 已因成功率 0.927 未达到 0.95 而失败。
- 自我精度:适中 \(\gamma_{self}\) 应同时优于两个端点,并展示承诺—恢复权衡;若端点最佳或两个读出均不变,则该操作化失败。T2 暂未触发此条件。
- H-Bridge:探索降低冲突的效果应依赖“偏好可更新”和“模型含自身局限”同时成立;若桥内外效应差小于 1,设计不可区分。T3 暂未触发此条件。
- 干预知识:含混杂的任务中,主动干预者的因果误差应低于等量纯观察者;若无差异,知行合一的因果弱版失败。
- 蒸馏:规划后蒸馏应在保留迁移性能时降低行动延迟;若没有速度收益或迁移明显恶化,技能层映射失败。
- 顿渐机制:连续证据可伴随 MAP 结构选择的离散翻转;若纯参数学习者出现同样跳变,或结构模型没有阈值行为,该解释失去区分力。
- 元觉知:可更新的二阶精度应在规则改变后比固定注意增益更快恢复校准,且不损害稳定期辨别力;否则该建模提议被削弱。
10. 不宣称清单
- 不宣称佛学、道家思想或开悟已被模拟证明。
- 不宣称自由能原理解决了意识难题,也不把变分自由能无条件等同热力学自由能。
- 不把苦等同奖励预测误差、负奖励或单个 KL 项。
- 不把无我等同删除自我状态、人格解体、失能或免除责任。
- 不把空等同虚无主义、统计不确定性或“万物皆信息”。
- 不把无为等同不行动、随机策略、最低能耗或某个温度极限。
- 不把中道等同参数取 0.5,也不把顿悟等同神经网络相变。
- 不把知行合一等同“先做再说”,更不把系统内紧耦合当作集中授权的正当性。
- 不把良知等同奖励函数,不把道等同生成过程或 Solomonoff 先验。
- 不把玩具实验、工程成功或吸引子图升级为本体论证据。
- 不宣称传统内部只有一种立场,也不宣称这里的桥接具有未经比较的新颖性。
11. 良知从哪里来:心智理论、博弈与业力
更新 · 2026-09-27 第二轮预注册模型 C1–C4 与事后探索臂均已完成;第一轮判定保持不变。
读者提出的直觉与一次性定理
一个值得检验的直觉是:共享相近心智模型的行动者反复相遇时,良知可能成为一种内化工具,帮助群体逃离囚徒困境。这个说法在此作为中性研究假说,而不是结论。严格边界是:在一次性囚徒困境中,若效用仍只有自己的物质收益,心智理论(ToM)只改善对他者行动的预测,并不改变背叛严格占优;知道“对方像我”也不自动让对方的利益进入我的目标。
加入他者关切权重 (U_i=\pi_i+w\pi_j) 后,合作同时优于两种背叛应对所需的一般阈值为:
严格偏好时把 ">=" 换成 ">"。当对方合作,(w=1) 足够当且仅当 (2R>T+S);当对方背叛,还需要 (T+S\geq2P)(严格偏好为 (T+S>2P)),而囚徒困境的定义 (T>R>P>S) 并不保证这一点。例如 (T=4,R=3,P=2,S=0) 时恰好打平。
业力只能分四层映射
| 层 | 有限形式对应 | 边界 |
|---|---|---|
| K1 社会声誉 | 行为被观察、评价,再经第三方帮助回流;对应间接互惠 | 需要观察者和同代公共声誉,不能等同全部业力 |
| K2 按意图评价 | 观察者推断意图后评价;可扩展 standing 等规范 | 需额外的 ToM 准确率与误判模型;AN 6.63 以“思”(cetanā)说业 |
| K3 内在习气 | 有记忆、路径依赖的内部状态或滞回 | 第一轮预注册滞回判据失败;行为状态不等同意识流 |
| K4 教义业报 | 无可靠博弈论对应 | MN 135 所涉业果不在本文形式化范围内 |
第一轮预注册结果
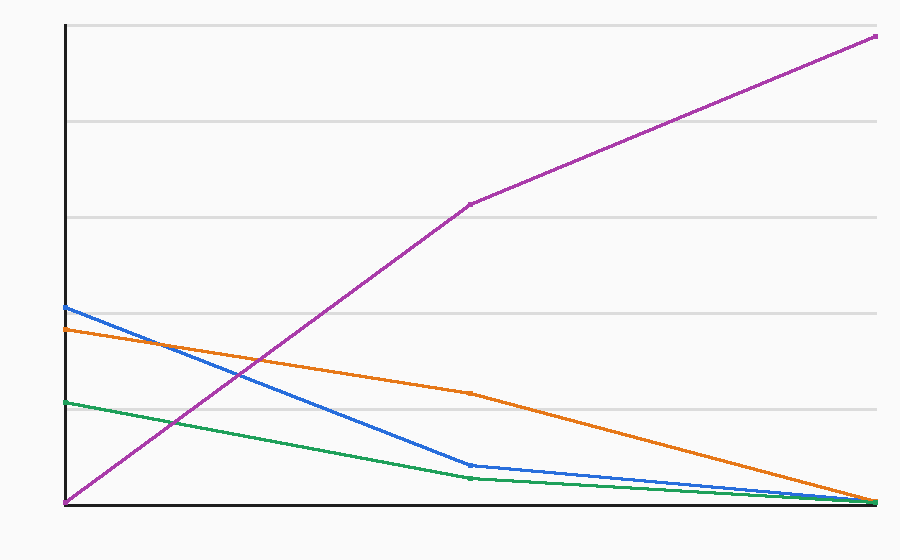
- 有噪声重复囚徒困境:否决。10% 行动与观察噪声下,固定权重良知型末期占比约 8.3%,低于预注册 10% 否决线,且跨重复不稳定。它的具体相对弱点是对 TFT,后者保留 23.4%;WSLS 仅保留 5.7%。25% 噪声下,三种合作机制都坍塌到约 0.7%–0.8%。
- 间接互惠:通过有限判据。在 10% 和 25% 评定误差下,standing 的平均收益均高于 image scoring;这只支持公开声誉规则的有限稳健性。
- 滞回:失败。轨迹有双稳态外形,但没有满足预注册的相邻冲击离散阈值;不能把预先构造的曲线当成现实良知稳定性的证据。
- 一次性匿名帮助与反合谋:通过。他者关切模型捐赠率为 49.74%,纯互惠模型为 0;纳入局外受害者后模型拒绝合谋,而只算联盟福利的规则加入。这说明近因偏好可以表达差异,不解释它如何产生,也不证明行为具有道德价值。
第二轮预注册结果
- C1 演化保留:否决。在中等重复概率、线索不完美时,两种良知类型仅约 0.5%–0.8%,远低于预注册的 10% 保留线;下表四个环境中伪装者约为 24%–35%。TFT、WSLS 和纯自利心智理论更低,仅约 0.05%–0.19%。因此良知并非独有地脆弱,在 C1 中的保留率还高于这些反应式合作机制,但没有一种具有演化稳定性。
- C3 滞回:通过,但仅是机制演示。预先写入自强化与社会阈值的方程产生约 0.15 的社会回线面积,而非社会对照约为 0。这说明该动力学能产生路径依赖,不证明现实良知具有同样机制。
- C2 按意图评价的声誉:狭窄通过。在较高执行误差下,意图识别准确率约 0.9 时,若干规则将合作率提高约 2.5–3.9 个百分点;效果并非普遍存在,不能简化成“加入意图推断总会改善合作”。
- C4 卡特尔预测:失败;触发两项否决。只扩大同情范围并不能阻止集体伤害;即使完整纳入局外受害者,全员合谋仍可保持为均衡。偏好修复需要制度修复,例如改变退出、协调或阻断伤害的结构。
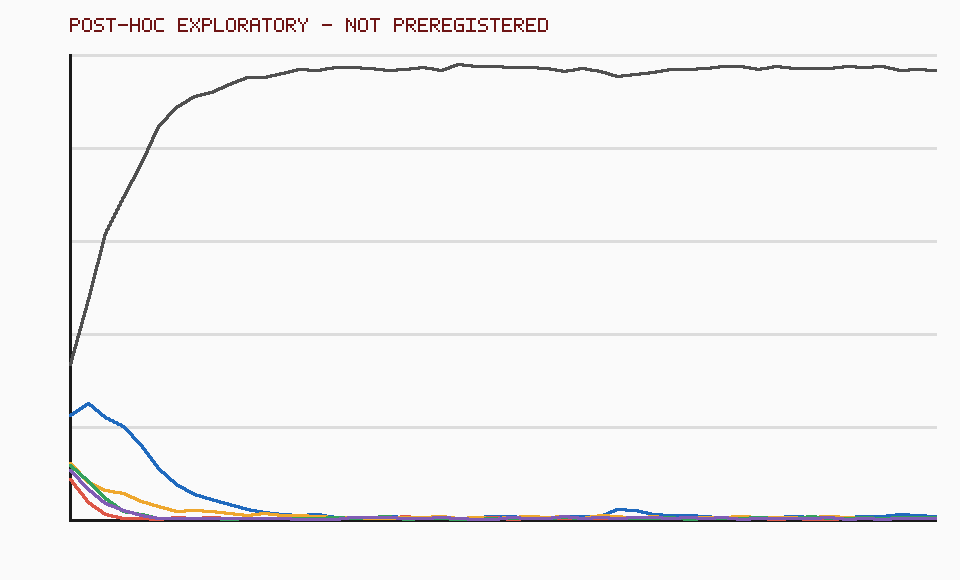
事后探索:条件化良知权重(非预注册)
各策略最终种群占比
| 实验臂 / 环境 | 最终或末期种群占比均值 |
|---|---|
| 第一轮 · 噪声 0 | 良知 41.3%;TFT 36.6%;WSLS 21.5%;ALLD 0.6% |
| 第一轮 · 噪声 0.10 | 良知 8.3%;TFT 23.4%;WSLS 5.7%;ALLD 62.6% |
| 第一轮 · 噪声 0.25 | 良知 0.7%;TFT 0.8%;WSLS 0.7%;ALLD 97.7% |
| 第二轮 C1 · prep 0.25,a 0.8 | 良知植入 0.55%;良知侵蚀 0.75%;SELF_TOM 0.16%;TFT 0.07%;WSLS 0.06%;ALLD 22.51%;SELF 52.21%;MIMIC 23.56% |
| 第二轮 C1 · prep 0.25,a 1.0 | 良知植入 0.53%;良知侵蚀 0.78%;SELF_TOM 0.19%;TFT 0.07%;WSLS 0.07%;ALLD 41.16%;SELF 21.91%;MIMIC 35.12% |
| 第二轮 C1 · prep 0.50,a 0.8 | 良知植入 0.48%;良知侵蚀 0.48%;SELF_TOM 0.09%;TFT 0.05%;WSLS 0.06%;ALLD 29.35%;SELF 37.98%;MIMIC 31.35% |
| 第二轮 C1 · prep 0.50,a 1.0 | 良知植入 0.46%;良知侵蚀 0.53%;SELF_TOM 0.08%;TFT 0.06%;WSLS 0.07%;ALLD 26.28%;SELF 37.03%;MIMIC 35.38% |
| 事后探索臂 | 条件权重 0.82%;固定权重 0.38%;TFT 0.6%;WSLS 0.5%;GTFT 0.5%;ALLD 97.2% |
三组经典张力
- 孟子“孺子入井”的三项排除:“非所以内交于孺子之父母也,非所以要誉于乡党朋友也,非恶其声而然也”,在近因层面分别排除直接互惠、声誉回流和仅为消除自身不适的解释。
- 王阳明《大学问》的范围梯度:一体之仁从孺子延至鸟兽、草木、瓦石;到瓦石处既无可建模的心智,也不可能互惠,因此相似度权重 (w s_{ij}) 归零而经典主张仍延伸,正面标出模型边界。
- 《庄子·胠箧》“盗亦有道”:合作规范也可服务盗贼集团与卡特尔,所以合作不等于道德。相似度加权还天然预测狭隘利他:更照顾相似者可能与群际冲突共同演化。
近因、终极因与明确分歧
终极层解释某种 (w>0) 的倾向为何可能在选择、伙伴挑选或声誉环境中被保留;近因层描述当事人此刻直接体验同情、羞耻或是非判断,而不计算回报。承诺装置能使两层相容,但不能覆盖无回报者、瓦石或规范权威。两轮预注册结果把边界画得更清楚:固定权重在第一轮噪声环境中失败,第二轮可演化权重也未建立;构造出的社会滞回与按意图评价分别展示了记忆和意图区分的有限功能,却没有推翻演化否决。理论上的承诺功能与更广滞回类比仍只是待检验机制,不能替代这些模型的经验判决。
它还可能给出与“致良知”相反的方向预测:演化/承诺叙事常预测,明确知道是一次性互动后,深思会削弱直觉合作;Rand 等(2012)报告了这一方向,但 Bouwmeester 等(2017)的多实验室注册复现未成功,因此经验状态不确定。致良知则预期反思去除遮蔽后使良知更强。
本节不宣称
- 不宣称博弈论证明了良知、良知只是开明自利,或心智理论会自动产生合作。
- 不把合作等同道德,不把业力等同声誉,也不把一次性玩具结果外推为真实人类因果机制。
- 不把 K1 的成功冒充 K2–K4,不把内化权重当作“善”的定义。
- 不以第二轮的狭窄通过覆盖其否决结果,也不把事后探索当成预注册确认。
- 不以已撤稿的 Whitehouse 等(2019)作为证据。
12. 参考文献
只列两份研究稿中原本带有链接的条目。“已核验”沿用稿件的核验标记;本次合并未重新逐条访问外部页面。其余一律标为“未核验”。
- Friston, K. (2010). “The free-energy principle: a unified brain theory?” Nature Reviews Neuroscience, 11, 127–138. DOI(已核验)
- Todorov, E. (2007). “Linearly-solvable Markov decision problems.” NeurIPS 19. Proceedings(已核验)
- Kappen, H. J. (2005). “Path integrals and symmetry breaking for optimal control theory.” JSTAT, P11011. arXiv(已核验)
- Ortega, P. A., & Braun, D. A. (2013). “Thermodynamics as a theory of decision-making with information-processing costs.” Proceedings A. arXiv(已核验)
- Leike, J., & Hutter, M. (2015). “Bad Universal Priors and Notions of Optimality.” COLT / PMLR 40. Proceedings(已核验)
- Laukkonen, R. E., & Slagter, H. A. (2021). “From many to (n)one.” Neuroscience & Biobehavioral Reviews, 128, 199–217. PubMed(已核验)
- Van Dam, N. T., et al. (2018). “Mind the Hype.” Perspectives on Psychological Science, 13(1), 36–61. PubMed(已核验)
- Seth, A. K. (2013). “Interoceptive inference, emotion, and the embodied self.” Trends in Cognitive Sciences, 17, 565–573. PubMed(已核验)
- Deane, G. (2020). “Losing Ourselves: Active Inference, Depersonalization, and Meditation.” Frontiers in Psychology. PMC(已核验)
- Sandved-Smith, L., et al. 相关元觉知与深参数主动推断工作。arXiv(未核验)
- Wang Yangming. Instructions for Practical Living and Other Neo-Confucian Writings, trans. Wing-tsit Chan (1963). Open Library(已核验书目)
- Dao De Jing. Chinese Text Project(已核验入口;章节版本仍须单独核对)
- 早期佛典检索入口:SN 12、SN 22.59、SN 56.11、DN 22(已核验入口;传统解释不唯一)
- Axelrod, R., & Hamilton, W. D. (1981). “The evolution of cooperation.” Science, 211, 1390–1396. DOI(已核验)
- Nowak, M. A., & Sigmund, K. (1998). “Evolution of indirect reciprocity by image scoring.” Nature, 393, 573–577. DOI(已核验)
- Nowak, M. A., & Sigmund, K. (2005). “Evolution of indirect reciprocity.” Nature, 437, 1291–1298. DOI(已核验)
- Choi, J.-K., & Bowles, S. (2007). “The coevolution of parochial altruism and war.” Science, 318, 636–640. DOI(已核验)
- Rand, D. G., Greene, J. D., & Nowak, M. A. (2012). “Spontaneous giving and calculated greed.” Nature, 489, 427–430. DOI(已核验)
- Bouwmeester, S., et al. (2017). “Registered Replication Report: Rand, Greene, and Nowak (2012).” Perspectives on Psychological Science, 12, 527–542. DOI(未核)
- 《孟子·公孙丑上》“孺子入井”。Chinese Text Project(已核验原典入口)
- 王阳明《大学问》“一体之仁”。维基文库(已核验原典入口)
- 《庄子·胠箧》“盗亦有道”。Chinese Text Project(已核验原典入口)
- AN 6.63(业与意图)。SuttaCentral(已核验入口);MN 135(业报)。SuttaCentral(已核验入口)
Whitehouse, H., et al. (2019). “Complex societies precede moralizing gods throughout world history.” Nature, 568, 226–229.撤稿声明(已撤稿;不作证据)
数学入门导读
读者入门小抄:佛道 × 决策理论页面里的"硬概念"
写给谁:做过 AI 实践、对佛学道家有深度兴趣、但不是数学专业的读者。 怎么用:每个概念先用 1–3 句字面说明它到底是什么(不用比喻代替机制),再给 1–2 个最好的入门资料(优先免费)。遇到页面里不认识的词,按 Ctrl+F 查。 来源核验:所有链接于 2026-09-27 实测可打开。标 ⚠️ 的"免费"属性未核。
一句总提醒:下面这些都是工具。一个概念能写成公式,不代表它说中了修行里真实发生的事——页面"形式化在哪里失效"一节同样重要。
一、描述"一个 agent 在世界里做决定"
马尔可夫决策过程(MDP) 一种描述决策问题的格式:有一组状态,每一步 agent 选一个动作,环境按固定的概率转移到下一个状态并给一个奖励,目标是选一套"在每个状态下该做什么"的规则(策略)让长期累计奖励最大。"马尔可夫"的意思是:下一步只取决于当前状态和动作,不取决于更早的历史。
- 入门:Sutton & Barto《强化学习》第 3 章(免费全书)http://incompleteideas.net/book/the-book-2nd.html
- 速查:Wikipedia Markov decision process https://en.wikipedia.org/wiki/Markov_decision_process
部分可观测 MDP(POMDP) MDP 的一个版本:agent 看不到真实状态,只收到带噪声的观测,所以它必须维持一个"我现在可能在哪个状态"的概率分布(信念),并按信念做决定。主动推断与本页的 T2 实验都用这种格式。
- 入门:Wikipedia https://en.wikipedia.org/wiki/Partially_observable_Markov_decision_process
- 经典原文:Kaelbling, Littman, Cassandra 1998 https://doi.org/10.1016/S0004-3702(98)00023-X(非免费)
奖励预测误差(RPE) "实际得到的奖励"减去"原本预期的奖励"。强化学习用它来更新预期;神经科学中,多巴胺神经元的放电在很多实验里与这个量相关。页面强调:苦 ≠ RPE。
- 入门:Sutton & Barto 第 6 章(时序差分)与第 15 章(神经科学)http://incompleteideas.net/book/the-book-2nd.html
- 原文:Schultz, Dayan, Montague 1997
二、概率与信念
贝叶斯更新 一种按规则修改信念的方法:新的信念(后验)正比于"原来的信念(先验)× 如果这个假设为真,看到当前证据的可能性(似然)"。证据越出乎某个假设的预料,那个假设的份量就降得越多。
- 入门(视频):3Blue1Brown《贝叶斯定理》https://www.youtube.com/watch?v=HZGCoVF3YvM
- 入门(免费书):Downey《Think Bayes 2》https://allendowney.github.io/ThinkBayes2/
先验精度(precision) 精度 = 方差的倒数,即一个信念"有多确定、多难被证据改动"。高精度的先验会压过与之矛盾的观测;低精度的先验容易被证据改写。页面里的 γ_self、γ_C 就是"关于自我的先验""关于偏好结果的先验"的精度。
- 入门:Bogacz 2017,自由能框架教程 https://doi.org/10.1016/j.jmp.2015.11.003 ⚠️
- 补充:Smith, Friston, Whyte 2022 分步教程 https://doi.org/10.1016/j.jmp.2021.102632
最大后验(MAP)/ 贝叶斯模型比较 MAP = 在所有候选里挑后验概率最高的那一个。模型比较 = 把"哪一种结构的模型更能解释数据"本身当作要推断的量;证据可以连续累积,但"排第一的模型"会在某个时刻离散地换人(页面用它来刻画顿与渐)。
- 入门:Wikipedia https://en.wikipedia.org/wiki/Maximum_a_posteriori_estimation
- 深入(免费):MacKay《信息论、推断与学习算法》第 28 章 http://www.inference.org.uk/itprnn/book.html
KL 散度 衡量"用分布 Q 去近似分布 P 时损失了多少信息"的一个数:两者完全相同时为 0,差得越多越大;它不对称。本页把"控制代价"定义为"实际行为分布"相对于"什么都不做时的自然分布"的 KL 散度。
- 速查:Wikipedia https://en.wikipedia.org/wiki/Kullback%E2%80%93Leibler_divergence
- 深入(免费):MacKay 第 2 章 http://www.inference.org.uk/itprnn/book.html
Solomonoff 先验 一个理论上的"通用先验":给每个可能的世界规律分配概率,描述越短的规律概率越高(按生成它的最短程序长度)。它有漂亮的收敛定理,但不可计算,只能作理论参照。页面只把"道 = Solomonoff 先验"列为修辞性对应。
- 入门(免费):Rathmanner & Hutter 2011 https://arxiv.org/abs/1105.5721
模型类、粗粒化、不可识别 模型类 = 你允许自己考虑的一族候选模型;粗粒化 = 把许多细节变量合并成少数宏观变量;不可识别 = 两种不同的内部结构产生完全相同的可观测数据,因此仅凭数据无法区分。页面用它们作"空性"在工程层面的部分对应(强度只到"部分")。
- 速查:Wikipedia https://en.wikipedia.org/wiki/Identifiability ;https://en.wikipedia.org/wiki/Coarse-grained_modeling
三、把"行动"写成"推断"
主动推断 / 自由能原理 一个理论框架:agent 带有一个关于"观测如何产生"的生成模型,它通过两种方式减小一个叫"变分自由能"的量——改信念(感知)和改世界让观测符合预期(行动);选策略时用"期望自由能",其中包含"离偏好结果多远"(风险项)和"能学到多少"(信息增益)。它是建模框架,作为"大脑定律"有争议。
- 入门(免费书):Parr, Pezzulo, Friston 2022《Active Inference》https://direct.mit.edu/books/oa-monograph/5299/Active-InferenceThe-Free-Energy-Principle-in-Mind
- 分步教程:Smith, Friston, Whyte 2022 https://doi.org/10.1016/j.jmp.2021.102632
变分自由能 vs 热力学自由能 变分自由能是一个关于信念的统计量(模型对观测的"惊讶度"的上界);热力学自由能是物理系统的能量量。二者公式形状相似,但不是同一个东西。
- 速查:Wikipedia(含批评小节)https://en.wikipedia.org/wiki/Free_energy_principle
元觉知 / 二阶精度 "二阶"推断 = 不是推断外界,而是推断"我自己的注意力/信念该给多大精度"。页面用它作"止观、元觉知"的计算提案。
- 原文:Sandved-Smith et al. 2021 https://doi.org/10.1093/nc/niab018
控制即推断(control as inference) 一种数学改写:引入一个"这一步是否最优"的虚拟变量,令其概率随奖励指数增长;于是"找最优策略"就变成"在'最优'这一条件下,推断最可能的行动轨迹",结果自然带有"尽量保持随机"的熵项。
- 入门(免费):Levine 2018 教程 https://arxiv.org/abs/1805.00909
KL 控制 / 线性可解 MDP(LMDP)/ 被动动力学 被动动力学 = 如果 agent 什么都不做,系统自己会怎样演化。LMDP 把每一步的代价写成"状态代价 + 实际转移相对被动动力学的 KL 散度";这种写法下最优控制有闭式解:最优转移 = 被动转移 × 目标价值的指数,再归一化。页面据此把无为的一部分写成"顺着自然动力学,只在关键处加最小控制"。
- 原文(免费 PDF):Todorov 2006 NIPS https://homes.cs.washington.edu/~todorov/papers/TodorovNIPS06.pdf
- 系统表述:Todorov 2009 PNAS https://doi.org/10.1073/pnas.0710743106
风险项 在主动推断的期望自由能里,风险项 = "按当前策略预计会看到的结果分布"与"偏好的结果分布"之间的 KL 散度。偏好越僵硬、结果越不可控,这一项就越长期居高不下——页面用它近似"求不得"的冲突。
- 见 Smith et al. 2022 https://doi.org/10.1016/j.jmp.2021.102632
摊销推断 / 蒸馏 摊销推断 = 不再对每个新情况从头慢慢算,而是训练一个网络直接把输入映射到答案。蒸馏 = 用一个慢而强的模型产生的输出,训练一个快的小模型去模仿它。页面用它们刻画"知行合一"的技能层。
- 入门(免费):Kingma & Welling 2019 https://arxiv.org/abs/1906.02691
- 蒸馏原文(免费):Hinton, Vinyals, Dean 2015 https://arxiv.org/abs/1503.02531
赋能(empowerment) agent 的动作序列与若干步后的状态之间的最大信息量(信道容量)。赋能高 = 从这里出发,不同的动作能可靠地到达很多不同的未来。
- 入门(免费):Salge, Glackin, Polani 2013 https://arxiv.org/abs/1310.1863
四、因果
因果干预(do 算子)/ 混杂 / 结构因果模型 结构因果模型 = 用"谁决定谁"的方程与箭头图写下变量之间的生成机制。P(Y | X) 是"观察到 X 时 Y 的分布",P(Y | do(X)) 是"强行把 X 设为某值后 Y 的分布";存在混杂变量时两者一般不同,有些因果效应只能靠干预(行动)才能确定。页面据此给出"知而不行,只是未知"的一个严格弱版本。
- 入门(免费):Pearl 2009 https://doi.org/10.1214/09-SS057
- 课程(免费):Brady Neal《因果推断导论》https://www.bradyneal.com/causal-inference-course
五、动力学与实验方法
吸引子 / 负反馈 / 相变 吸引子 = 动力系统随时间会被拉向并停留的状态;负反馈 = 偏离后会产生把系统推回来的作用;相变 = 某个参数越过临界值时,系统的稳定状态发生突然、质的改变。
滞回(hysteresis) 系统当前状态不只取决于当前条件,还取决于它是怎么走到这里的:参数往上调时在 a 点跳变,往回调时要到更低的 b 点才跳回去,中间形成一个"环"。区分真滞回与单纯滞后的办法:把参数调得无限慢,滞后会消失,真滞回的环还在。
- 速查:https://en.wikipedia.org/wiki/Hysteresis
- 经典例子:Scheffer et al. 2001 https://doi.org/10.1038/35098000
Pareto 前沿 / "拐点" 有两个互相冲突的目标时,Pareto 前沿 = 所有"无法在不牺牲一个目标的前提下改进另一个"的方案;拐点 = 前沿上"再多花一点代价、收益就几乎不涨"的位置。页面 T1 想找的"无为点"就是这个拐点(结果未达预注册阈值)。
预注册 / kill 条件 在跑实验之前写下"什么结果算成功、什么结果算失败",事后不能改。它防止事后挑选对自己有利的解读。
- 入门:Nosek et al. 2018 https://doi.org/10.1073/pnas.1708274114 ⚠️
- 速查:https://en.wikipedia.org/wiki/Preregistration_(science)
双重差分 "处理组的变化量"减去"对照组的变化量"。页面 T3 中用它算桥条件与探索的交互效应。
六、多智能体:博弈与良知
心智理论(ToM)/ level-k / I-POMDP 心智理论 = 把他者当作有自己信念、欲望、意图的 agent 来建模,并据此预测其行为;计算版本常见做法是"假设对方近似理性地规划,再从其行为反推其目标与信念"(贝叶斯逆规划)。level-k = 限定"我想你想我想……"的层数;I-POMDP = 把"对他者的模型"直接放进自己的状态里做规划。
- 入门:SEP《作为理论的民间心理学》https://plato.stanford.edu/entries/folkpsych-theory/
- 计算入门:Jara-Ettinger 2019 https://doi.org/10.1016/j.cobeha.2019.04.010 ;机器版:Rabinowitz et al. 2018 https://arxiv.org/abs/1802.07740
Nash 均衡 一组策略,使得在其他人都不改的前提下,没有任何一个人能靠单方面改变自己的策略而得到更多。它不等于"对大家最好",也不等于公平或道德。
- 入门(交互,免费):Nicky Case《信任的演化》https://ncase.me/trust/
- 教材:Osborne & Rubinstein《博弈论教程》作者页 https://arielrubinstein.tau.ac.il/books.html ⚠️
囚徒困境(PD) 两人各自选择合作或背叛;收益排序为:我背叛你合作(T)> 都合作(R)> 都背叛(P)> 我合作你背叛(S)。无论对方怎么选,背叛都让我多得,所以两个"理性"玩家都背叛,结果都拿 P,而都合作本可以都拿更多的 R。
- 入门(免费):SEP《囚徒困境》https://plato.stanford.edu/entries/prisoner-dilemma/
重复博弈 / 无名氏定理 同样两人反复玩同一个博弈,并且足够看重未来时,"你背叛我就报复"之类的条件策略可以让合作成为均衡。无名氏定理进一步说:只要足够有耐心,任何让每个人至少拿到"最坏保底"以上的收益组合都能成为均衡——包括不公平的。
- 入门:SEP《囚徒困境》"重复 PD"一节 https://plato.stanford.edu/entries/prisoner-dilemma/
- 速查:https://en.wikipedia.org/wiki/Folk_theorem_(game_theory)
间接互惠 / 声誉 / 评价规范 "我帮你,别人帮我":帮不帮某人,取决于他的声誉,而声誉由旁观者按某条评价规范打分(例如"帮好人算好、拒绝坏人也算好")。只有少数规范能在有误差时稳定维持合作;旁观者看法不一致时合作容易瓦解。本页把它作为业力"社会面"的形式类比。
- 入门(开放获取):Okada 2020 https://doi.org/10.3390/g11030027
社会偏好 / 不公平厌恶 在效用函数里加入与他人收益有关的项:例如 Fehr–Schmidt 模型中,自己比别人少会难受,自己比别人多也会难受。
- 原文:Fehr & Schmidt 1999 https://doi.org/10.1162/003355399556151
康德式优化(Roemer) 不问"别人不变时我改什么最好",而问"如果所有人都照同样方式改变行动,我是否希望这样"。在对称囚徒困境里,它选合作。
- 原文:Roemer 2010 https://doi.org/10.1111/j.1467-9442.2009.01592.x
承诺装置 一种事先把自己"锁住"的安排,使自己在未来即使有诱惑也不会背叛;因为锁住是可信的,别人更愿意与你合作。Frank 认为道德情感(如内疚、义愤)就起这种作用:正因为它不计算,才可信。
- 原书:Frank 1988《理性中的激情》https://openlibrary.org/works/OL1980817W
程序均衡 如果双方提交的是可以互相读取的程序,"只有当对方程序能被证明会和我合作时才合作"这类程序可以在单次囚徒困境中达成合作。前提是代码透明,人和当前神经网络都不满足。
- 原文:Tennenholtz 2004 https://doi.org/10.1016/j.geb.2004.02.002 ;Barasz et al. 2014 https://arxiv.org/abs/1401.5577
演化博弈 / 复制子动力学 把策略看作在种群中繁殖的"类型":收益高于平均的策略,所占比例增加。用它来问"哪种倾向(例如良知权重 w)会在长期中被选择出来"。
- 入门(免费):SEP《演化博弈论》https://plato.stanford.edu/entries/game-evolutionary/
时序社会困境(多智能体强化学习) 把囚徒困境扩展为网格世界里持续多步的行为(如过度采集公共资源),用强化学习 agent 研究合作如何涌现或瓦解;常见辅助手段有不公平厌恶奖励、社会影响奖励、对手塑造(LOLA)。
- 原文(免费):Leibo et al. 2017 https://arxiv.org/abs/1702.03037 ;综述:Dafoe et al. 2020 https://arxiv.org/abs/2012.08630
演化利他 vs 心理利他(近因 vs 终极因) 演化利他按对繁殖适应度的后果定义;心理利他按行为者动机定义(真心想帮别人)。SEP 指出两者在两个方向上都相互独立——这正是调和"良知是工具"与"孟子说良知不图回报"的关键区分。
- 入门(免费):SEP《生物学利他》https://plato.stanford.edu/entries/altruism-biological/
七、可以先跳过的
- Markov blanket:把系统内部与外部分开的一组"边界"变量,给定它们后内外统计独立;自由能原理用它定义"一个东西"。https://en.wikipedia.org/wiki/Markov_blanket
- 信息瓶颈:在"尽量压缩输入"与"尽量保留对目标有用的信息"之间取折中的方法。
相关阅读
理论主线索引 — 返回全站枢纽与分组目录。
- 我们提出它,然后自己杀掉它 —— 起心动念 = 换测度 | Macheng Shen — 已撤回的换测度类比展示了形式优美为何仍不足以确立经验主张。
- 懂得世界,不等于愿意合作 | Macheng Shen — 合作研究进一步区分事实理解、偏好修订与合作目标的形成。
- Information Dynamics 研究台账 · 未来可达性 | Macheng Shen — 研究台账把本页的支持、推测与负面结果纳入明确的主张状态。